TiroでAIエージェント連携するMCP・API実装ガイド
Tiroの会議データをMCP、REST API、Webhook、CLIでAIエージェントに接続し、議事録後の処理を自動化する開発者向け手順です。
要点
- Tiroの会議データは、リモートMCPサーバー(
https://mcp.tiro.ooo/mcp)、REST API(https://api.tiro.ooo)、Webhook、CLI(@theplato/tiro-cli)を組み合わせることでAIエージェントの実行コンテキストに接続できます。 - AIエージェントの導入により、製造業の現場で議事録作成時間が4時間超から30分へ短縮された事例があります。
- このページは技術接続を扱います。業務展開ではなく、会議メタデータ、文字起こし、要約を自動処理へ渡す実装に焦点を当てます。
AIエージェント連携で会議業務は何が自動化できるのか?
会議データをAIエージェントに渡すことで、議事録作成やその後の処理を自動化できる可能性があります。
会議の自動化で最初に狙うべき処理は、会議終了後に人が繰り返している事務作業の効率化です。
製造業の事例において、AIエージェントの導入により議事録作成時間が4時間超から30分へ短縮された事例が報告されています(リコー)。このような効率化は、録音の文字起こしだけでなく、会議後の情報をAIが処理しやすい形で扱うことで実現に近づきます。
情報を整理された形で保持することは、AIエージェントによる情報処理を検討する上での土台となります。これにより、人が情報を探し出し、他システムへ手動で転記する際の手間を軽減できる可能性があります。
MCPを使うとAIエージェント連携はどう標準化できるのか?
Model Context Protocol(MCP)は、AIエージェントのコンテキスト活用の分野で企業による採用が進んでいるプロトコルの一つです。
MCPは、AIエージェントが外部コンテキストを扱うためのインターフェースとして期待されています。Tiroは公式のリモートMCPサーバー(https://mcp.tiro.ooo/mcp)を提供しており、対話型のクライアントはOAuth、ヘッドレスなツールはAPIキーで接続すると、AIエージェントは会議の文字起こしやノートを、個別の独自連携ではなく統一された手順で参照できます(Tiro MCP概要)。
2026年5月24日時点で、公式のMCPレジストリには最新版のサーバーレコードが9,652件登録されています(Digital Applied、2026年)。同じ記事では、Stacklokの2026年のソフトウェアレポートをもとに、調査対象のソフトウェア組織の41%が限定的または本格的な本番環境でMCPサーバーを運用していると紹介されています(Digital Applied、2026年)。
普及の背景には、AIエージェントごとに個別の接続を実装する負担を減らせる点があります。CData Softwareは、MCPの利点として、AI支援ワークフローでのタスク完了が55%速くなることと、開発オーバーヘッドの30%削減を挙げています(CData Software、2025年)。
AnthropicのMCP SDKについては、2025年12月時点で月間ダウンロード数が9,700万件を超えたと報告されています(Digital Applied、2026年)。この数字は、MCPが実験的な接続方式から、開発者が日常的に組み込む接続層へ移りつつあることを示しています。
TiroでMCPを使う場合、基本設計は次のようになります。
| レイヤー | 役割 | 実装イメージ |
|---|---|---|
| AIエージェント | ユーザーの指示を解釈し、必要なツールを選ぶ | 「昨日の営業会議から次のアクションを抽出して」と依頼される |
| MCPクライアント | エージェント側で外部ツールを呼び出す | 接続先のMCPサーバーへ会議情報の取得を要求する |
| MCPサーバー | 外部データをAI向けツールとして公開する | 会議一覧や文字起こし取得などの操作を提供する |
| API | 実際のデータソースへアクセスする | メタデータや文字起こしを取得する |
公式MCPサーバーでは、ノートを list_notes(メタデータ)、search_notes(内容)、get_note_transcript(生の発言)の順に取得することが推奨されており、get_note_transcript はトークンを多く消費する最終手段とされています。社内の独自MCPサーバーにTiroのデータを組み込みたい場合は、REST APIを呼び出すツールを自前で定義します。REST APIでは、ノート詳細を GET /v1/external/notes/{noteGuid}、段落を GET /v1/external/notes/{noteGuid}/paragraphs で取得できます。以下は、Tiroの会議メタデータと段落を独自のMCPツールとして公開する場合の設計例です。
import { z } from "zod";

const envSchema = z.object({
  TIRO_API_BASE_URL: z.string().url().default("https://api.tiro.ooo"),
  TIRO_API_TOKEN: z.string().min(1),
});

const env = envSchema.parse(process.env);

async function fetchTiroNoteTranscript(noteGuid: string) {
  const noteResponse = await fetch(`${env.TIRO_API_BASE_URL}/v1/external/notes/${noteGuid}`, {
    headers: {
      Authorization: `Bearer ${env.TIRO_API_TOKEN}`,
      Accept: "application/json",
    },
  });

  if (!noteResponse.ok) {
    throw new Error(`Tiro note request failed: ${noteResponse.status}`);
  }

  const paragraphsResponse = await fetch(`${env.TIRO_API_BASE_URL}/v1/external/notes/${noteGuid}/paragraphs?size=1000`, {
    headers: {
      Authorization: `Bearer ${env.TIRO_API_TOKEN}`,
      Accept: "application/json",
    },
  });

  if (!paragraphsResponse.ok) {
    throw new Error(`Tiro paragraph request failed: ${paragraphsResponse.status}`);
  }

  return {
    note: await noteResponse.json(),
    paragraphs: await paragraphsResponse.json(),
  };
}

export const tools = {
  fetch_note_with_paragraphs: {
    description: "TiroのnoteGuidからノート詳細と会話段落を取得する",
    inputSchema: z.object({
      noteGuid: z.string(),
    }),
    async execute(input: { noteGuid: string }) {
      return fetchTiroNoteTranscript(input.noteGuid);
    },
  },
};
この例で重要なのは、AIエージェントに直接すべてのデータを渡さないことです。会議ID、対象期間、参加者、プロジェクト名などの条件で必要な会議だけを取り出し、最小限のコンテキストとして渡します。会議データは機密性が高いため、独自のMCPサーバー側で認可、監査ログ、データ最小化を設計する必要があります。
REST APIとWebhookでTiroデータをどう抽出するのか?
TiroのREST APIは、ノートのメタデータ、文字起こし、要約、ドキュメントをプログラムから取得するための接続面です。
REST APIは、特定の会議データを明示的に取得したいときに向いています。TiroのAPIドキュメントでは、ベースURL https://api.tiro.ooo でノート、文字起こし、要約、フォルダーなどを扱えること、レート制限がAPIキーごとに60秒あたり600リクエストであることが示されています(Tiro API概要)。
Webhookは、会議の状態変化などを起点に処理を開始したいときに活用されます。Recall.aiの実装例では、Webhookを使ってイベントを検知し、その後の処理を起動する仕組みが紹介されています(Recall.ai、2026年)。
Tiroでは、ノートのすべての処理が完了したときの note.ended や、ドキュメントの生成・更新・削除を知らせる note_document.generated、note_document.updated、note_document.deleted などのイベントを、Tiro Platformで登録したエンドポイントでHTTP POSTとして受け取れます(Tiro Webhookの概要)。
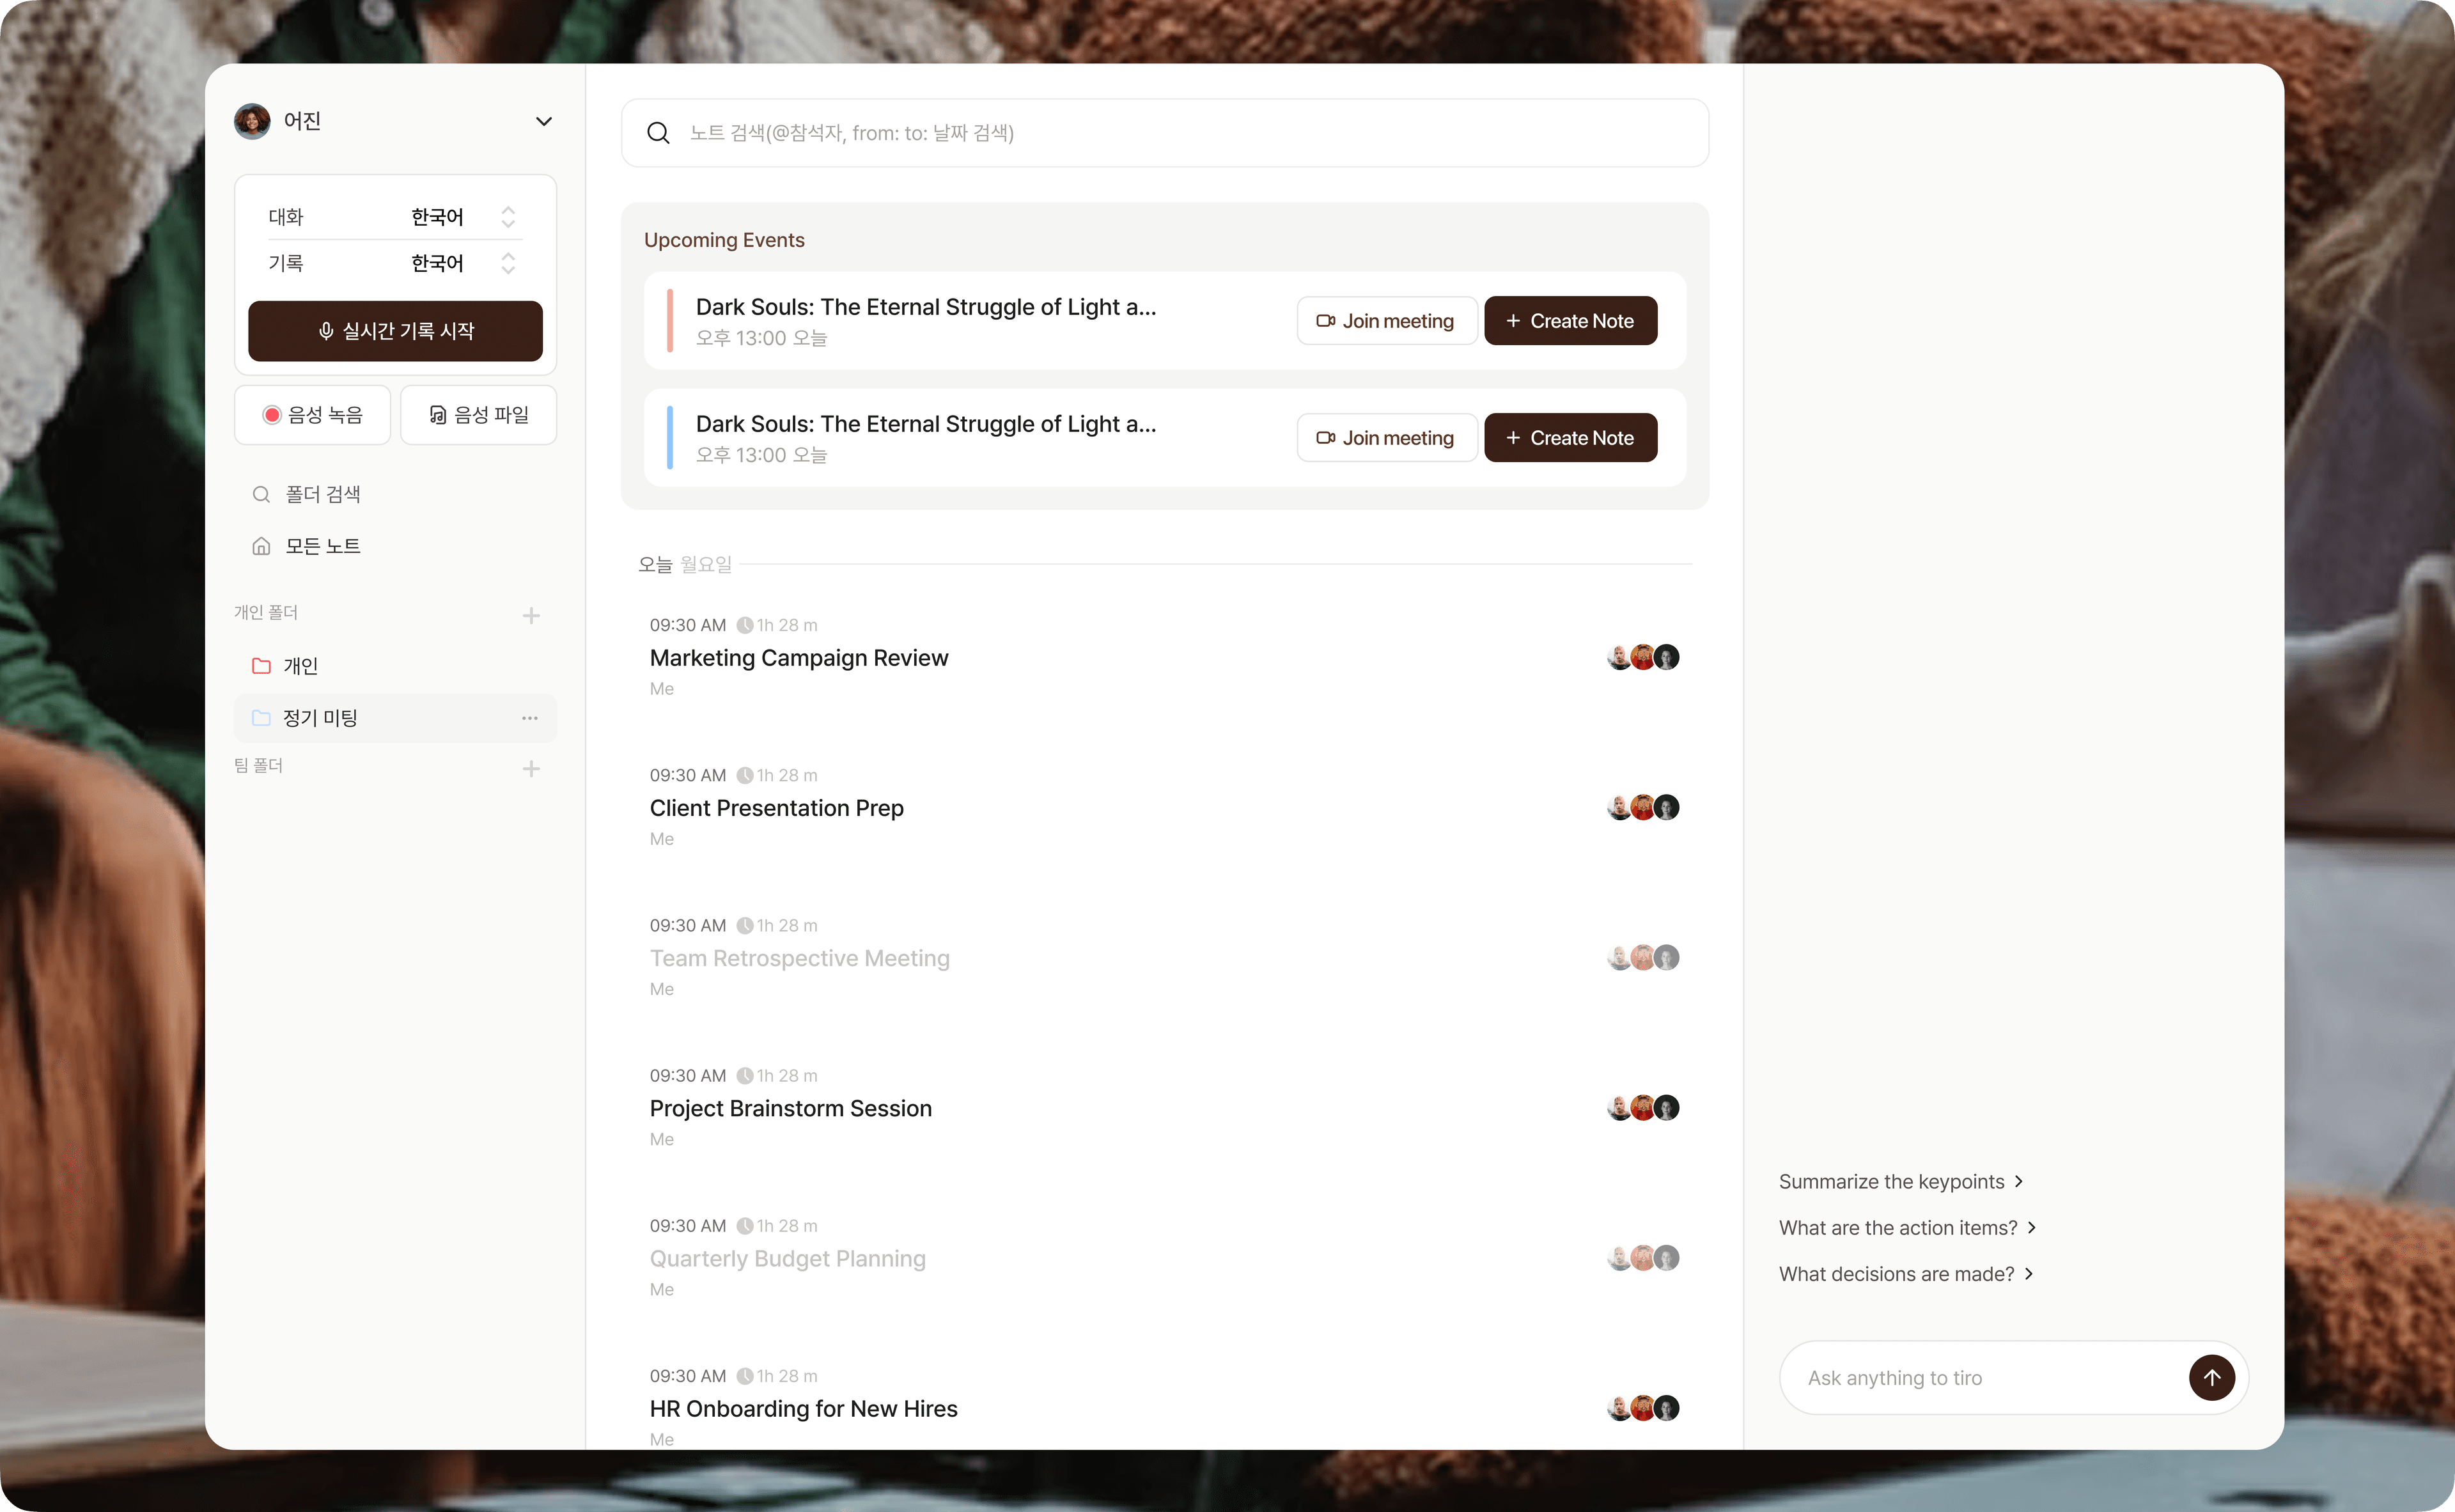
外部システムと連携する一般的な実装フローとしては、次のような構成が考えられます。
- イベントを検知するためのWebhook受信エンドポイントを用意する。
- 通知から必要な情報を取得し、非同期処理のキューに登録する。
- 必要に応じてAPIを呼び出し、詳細データを取得する。
- 取得したデータを要約などの後続処理へ渡す。
- 処理結果を適切なデータベースやストレージへ出力する。
- 処理ログを記録し、再試行可能な状態にする。
Webhook受信側では、イベントを受け取った直後に長い処理を実行しないほうが安全です。HTTPリクエストの中で要約や外部連携を完了させようとすると、タイムアウト、重複実行、部分失敗の扱いが難しくなります。Webhookは「処理開始の合図」として受け取り、実作業はキューやバックグラウンドワーカーで実行します。
以下は、Webhook受信からジョブ登録までの最小構成を示す疑似コードです。TiroのWebhookは、エンドポイントの設定時に発行されるシークレットキーを Authorization: Bearer ヘッダーに入れて送るため、受信側ではこの値を照合します。2xx以外の応答は指数バックオフで最大5回まで再送されるので、イベントの id で重複を除く設計にしておくと安全です。
import express from "express";

const app = express();
app.use(express.json());

app.post("/webhooks/tiro", async (req, res) => {
  if (req.get("authorization") !== `Bearer ${process.env.TIRO_WEBHOOK_SECRET}`) {
    return res.status(401).json({ error: "unauthorized" });
  }

  const event = req.body;

  if (!event.id || !event.type || !event.data?.resourceId) {
    return res.status(400).json({ error: "invalid webhook payload" });
  }

  await enqueuePostMeetingJob({
    eventId: event.id,
    eventType: event.type,
    resourceId: event.data.resourceId,
    receivedAt: new Date().toISOString(),
  });

  return res.status(202).json({ accepted: true });
});

async function enqueuePostMeetingJob(job: {
  eventId: string;
  eventType: string;
  resourceId: string;
  receivedAt: string;
}) {
  console.log("enqueue", job);
}

app.listen(3000);
REST API側の処理は、取得するデータを用途別に分けておくと保守しやすくなります。
| APIで取得する対象 | 活用例 | 保存先の例 |
|---|---|---|
| 会議メタデータ | 会議の分類 | データベース |
| 文字起こし | 内容の要約 | ナレッジベース |
| 生成ノート | 情報共有 | 社内Wiki |
CLIで会議データを一括エクスポートするには?
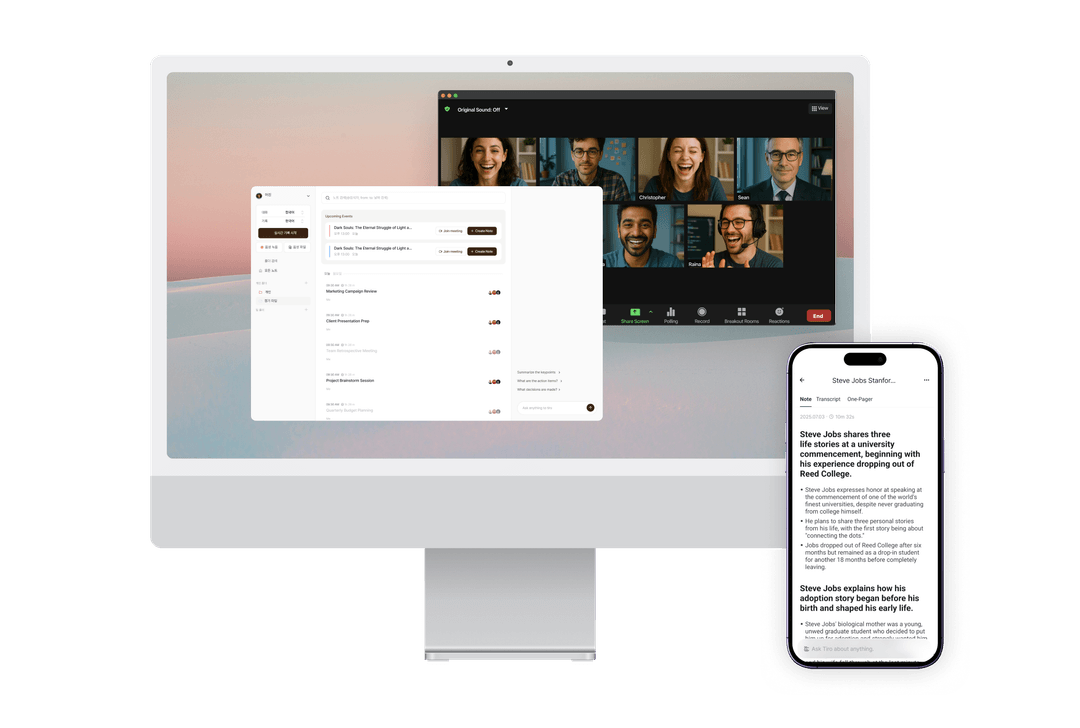
Tiroの公式CLI(npmパッケージ @theplato/tiro-cli)を使うと、MCPと同じTiro APIをシェル、CI、cron、AIエージェントから利用し、会議データをファイルへ書き出せます。
TiroのCLI概要では、会話の中でノートを読み取って推論するならMCP、結果をファイルやパイプで受け取りたいならCLIが適しているとされ、CLIの用途として一括エクスポート、ファイル操作、スクリプトが挙げられています(Tiro CLI概要)。たとえば、過去90日分の会議文字起こしを毎晩エクスポートする、特定チームの文字起こしだけを監査用ストレージへ保存する、AI検索用のインデックスを再構築する、といった処理ではCLIが扱いやすくなります。
CLIはNode.js 20以降で動作します。tiro auth login を実行するとブラウザでOAuth(Authorization Code + PKCE)のログインが始まり、認証情報はOSの資格情報ストア(macOSではKeychain)に保存されます。ブラウザを使えないCIなどの環境では、環境変数 TIRO_TOKEN にトークンを設定します(インストールと認証)。
ノートは tiro notes list、search、get、transcript で扱え、MCPの list_notes、search_notes、get_note、get_note_transcript と同じ範囲をカバーします。--json を付けると結果をNDJSONで出力し、取得系のコマンドは --output <path> で内容をファイルへ書き出せます。tiro notes transcript --format json の出力はMCPの get_note_transcript と同じ形式なので、既存のMCP用パーサーをそのまま使えます。
CLIによるエクスポートでは、用途に合わせて出力先を検討します。たとえば、長期保存や監査を目的としたストレージへの保存や、分析・集計を目的としたデータベースへの投入などが考えられます。
以下は、CLIでノートを検索し、文字起こしをファイルへ書き出す基本の流れです。
npm install -g @theplato/tiro-cli
tiro auth login
tiro notes search "Q3 Planning" --since 7d --json
tiro notes transcript <noteGuid> --output ./transcript.md
CLIを本番運用に入れる場合は、次の項目を最初から設計しておく必要があります。
- 効率的な取得: 必要なデータのみを取得し、重複を避ける設計を検討します。
- 耐障害性: 途中でエラーが発生した場合でも、再開可能な構成を考慮します。
- レート制御: APIの制限に合わせ、並列数とリトライ間隔を調整する。
- 秘密情報管理:
TIRO_TOKENやAPIキーをコードやログに残さず、シークレット管理サービスで扱う。 - データ保持: 書き出した文字起こしやノートの保存期間、削除手順、アクセス権限を明文化する。
MCP、API、Webhook、CLIはどう使い分けるべきか?
Tiro連携では、AIの対話にはMCP、データ取得にはAPI、イベント起動にはWebhook、一括処理にはCLIが向いています。
4つの接続面は競合するものではありません。会議後の自動化では、Webhookが処理の開始を知らせ、APIが必要データを取得し、CLIがまとめて再処理し、MCPがAIエージェントからの対話的な参照を受け持つ、という分担が自然です。
| 接続方式 | 最適な用途 | 典型的な質問や処理 | 実装上の注意 |
|---|---|---|---|
| MCP | AIエージェントが会議コンテキストを参照する | 「先週の顧客会議の決定事項をまとめて」 | AIに渡す範囲を最小化する |
| REST API | 特定の会議データを取得する | 会議IDから文字起こしを取得する | 認可、ページング、リトライを実装する |
| Webhook | 会議終了後に処理を起動する | 文字起こし確定後に要約ジョブを開始する | 即時処理ではなくキューに渡す |
| CLI | 過去データをまとめて処理する | 月次で全会議をアーカイブする | 差分処理と再実行性を確保する |
Tiroの開発者連携でよく使われる構成は、次のようなエンドツーエンドの流れです。
- 会議が終了し、Tiro側で文字起こしが利用可能になる。
- Webhook(例: ノートの処理完了を示す
note.ended)がバックエンドの受信URLへイベントを送る。 - バックエンドが会議IDをジョブキューに登録する。
- ワーカーがTiro REST APIからメタデータと文字起こしを取得する。
- LLM処理が要約、決定事項、担当者別タスクを生成する。
- 生成結果を社内ツールや検索基盤へ保存する。
- 後日のAIエージェントからの質問には、Tiroの公式MCPサーバー経由でノートを検索して応答する。
この構成では、リアルタイム性と再処理性を両立できます。会議直後の通知はWebhookで動かし、後から条件を変えた分析や再要約はCLIで走らせ、ユーザーからの自然言語質問にはMCPで応答します。
実装前に決めるべきセキュリティと運用設計は?
会議データ連携では、認可、データ最小化、監査ログ、保存期間を実装前に決める必要があります。
会議には、顧客情報、採用情報、財務情報、未公開の製品情報が含まれることがあります。AIエージェントが参照できる状態にするほど、アクセス制御とログ設計の重要性は高まります。
開発前に決めるべき項目は次のとおりです。
- アクセス範囲: AIエージェントが参照できる会議を、チーム、プロジェクト、参加者、期間で制限する。
- 認可モデル: ユーザー本人の権限で取得するのか、サービスアカウントで取得するのかを決める。
- データ最小化: 要約に不要な録音、発言者情報、添付情報をAI処理へ渡さない。
- 監査ログ: 誰が、いつ、どの会議データを、どのエージェント経由で参照したかを記録する。
- 保存期間: 文字起こし、録音、生成ノート、AI入力ログの保持期間を分けて定義する。
- 失敗時の扱い: APIエラー、Webhook再送、LLM生成失敗、外部ツール書き込み失敗を個別に処理する。
独自のMCPサーバーを実装する場合は、AIエージェントに公開するツール名と説明文もセキュリティ設計の一部です。たとえば、get_all_meetingsのような広すぎる操作よりも、search_meetings_by_projectやget_transcript_by_meeting_idのように入力条件が明確な操作のほうが制御しやすくなります。
REST APIとCLIでは、取得したファイルが開発者のローカル環境に残るリスクがあります。検証用のエクスポートであっても、出力ディレクトリ、暗号化、削除手順、ログマスキングを決めてから実行するべきです。
Tiro連携を小さく始める推奨アーキテクチャ
最初のTiro連携は、Webhook、API取得、要約保存の3点に絞ると、短期間で検証しやすくなります。
いきなりMCP、CLI、全社検索、CRM更新まで同時に作ると、失敗時の原因切り分けが難しくなります。最初のスコープは、会議終了後に文字起こしを取得し、要約とアクションアイテムを保存する処理に限定するのが現実的です。
推奨する最小構成は次のとおりです。
| フェーズ | 実装するもの | 成功条件 |
|---|---|---|
| 1 | Webhook受信とジョブ登録 | 会議イベントを取りこぼさず記録できる |
| 2 | Tiro REST APIから文字起こし取得 | 指定会議IDのデータを安定して取得できる |
| 3 | LLMによる要約とタスク抽出 | 人が確認できる形式で生成結果を保存できる |
| 4 | CLIによる再処理 | 同じ期間の会議を安全に再エクスポートできる |
| 5 | 公式MCPサーバーの接続 | AIエージェントが権限内の会議だけを参照できる |
Tiroの価値は、会議の詳細を残すことに加えて、その詳細を必要なタイミングでAIエージェントや社内ワークフローへ渡せる点にあります。まずは1つのチーム、1つの会議種別、1つの出力先に絞り、ログを見ながら対象を広げると、実装と運用の両方を調整しやすくなります。
FAQS